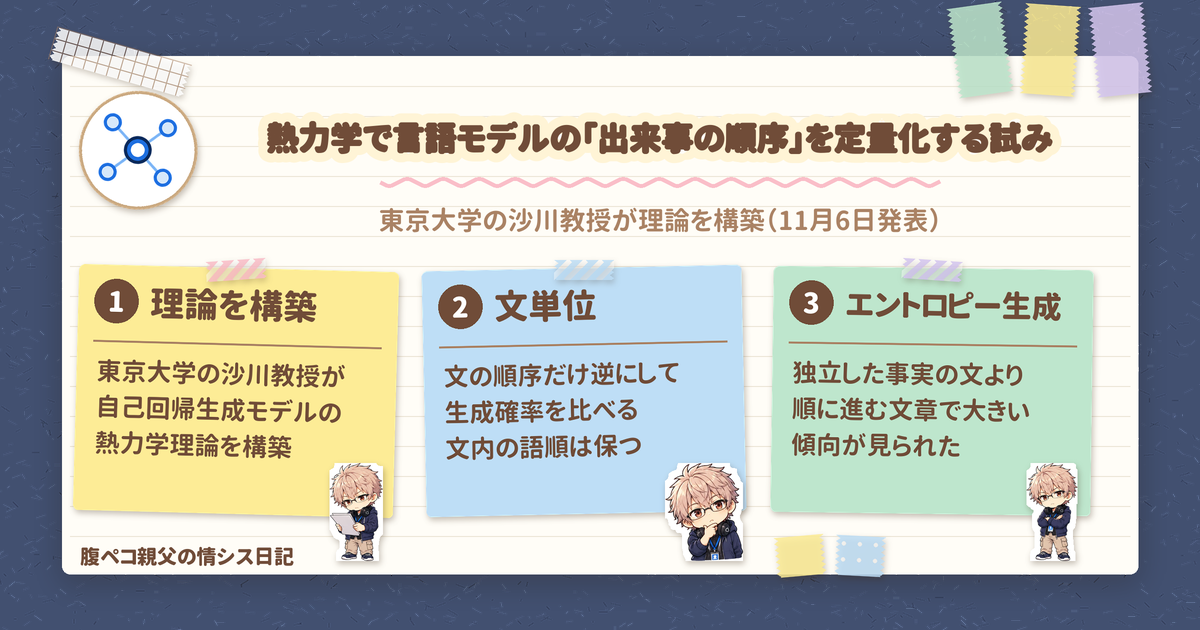
熱力学で言語モデルが学ぶ「出来事の順序」の定量化を試みる研究が発表されました。東京大学大学院工学系研究科が、2026年11月6日に発表したものです。物理工学専攻の沙川貴大教授が、熱力学の理論を構築しました。対象は、大規模言語モデル(LLM)などの「自己回帰生成モデル」です。AI の中身に興味がある人に関係する話題です。
結論から言うと、エントロピー生成を効率的に推定する方法が示されました。 さらに言語モデル向けに、「文単位」のエントロピー生成が導入されています。文の順序だけを逆にしたときの、起こりにくさを見る量です。
実験には、オープンモデル 2 つが使われました。その結果、文章に表れた出来事の順序関係が、モデルに反映されていることを「示唆する」結果が得られています。ただし、証明ではなく示唆の段階です。プレスリリースも、さらなる検証が望まれるとしています。
出典は、東京大学大学院工学系研究科のプレスリリースです。論文のページは、PRX Intelligence の掲載ページ(英語)です。論文は2026年11月5日(米国東部標準時間)に、オンライン版に掲載されました。プレスリリースは、東京大学と科学技術振興機構(JST)の連名です。
熱力学の「エントロピー生成」を生成モデルに当てはめた
自己回帰生成モデルは、出力の履歴をもとに次の出力を作るモデルです。たとえば、GPT などの文章生成モデルがそうです。過去の履歴をもとに、次のトークンを順に出していきます。トークンは、単語などの処理単位のことです。
一方、熱力学には「エントロピー生成」という量があります。時間の向きを逆にした状況の起こりにくさ(不可逆性)を表す量です。今回の理論は、この熱力学の考え方を自己回帰生成モデルに当てはめたものです。ポイントを表にまとめます。
| 項目 | 今回示されたこと |
|---|---|
| 扱う範囲 | トランスフォーマー(LLM の基盤)からカルマンフィルタまで、統一的に扱う |
| 推定の方法 | 考えられる過去の履歴をすべて並べなくても、エントロピー生成を効率的に推定できる |
| 中身の分解 | エントロピー生成を、各時刻に対応するゼロ以上の寄与の和として表せる |
また、論文の要旨(英語)は、対象として次の 5 つを挙げています。
- Transformers
- recurrent neural networks
- classical Kalman filters
- state space models
- Mamba
さらに要旨では、各時刻の寄与が 2 つに分かれるとしています。compression loss と model mismatch です。
非マルコフ過程でも、熱力学のエントロピー生成を推定
もう一つの山場が、非マルコフ過程への対応です。言語モデルの出力は、直前のトークンだけでは決まりません。それより前の文脈全体に左右されます。こうした時系列は、非マルコフ過程と呼ばれます。
ただし、その熱力学には未解明な点が多く残されています。また、観測データだけから確率を求めると、膨大なデータが要るという問題もありました。
そこで今回の研究は、自己回帰生成モデルに共通する構造に着目しました。その結果、非マルコフ過程でもエントロピー生成を効率的に推定できると示しています。
「コップが割れた」で考える、文単位のエントロピー生成
熱力学の考え方を言語モデルに当てはめるには、工夫が要ります。トークンの順序を全部逆にすると、文法が崩れてしまうからです。
そこで研究では、「文単位」のエントロピー生成を取り入れました。文の中の語順は保ったまま、文の順序だけを逆にする方法です。たとえば、プレスリリースには次の例があります。
- 元の順序: 「コップが床に落ちた。コップが割れた。」
- 逆の順序: 「コップが割れた。コップが床に落ちた。」
逆にすると、現実の出来事の描写として不自然になります。この 2 つの並びの生成確率を比べるのが、文単位の考え方です。そうすることで、言語モデルが現実世界の「出来事の順序」をどう学んでいるかを定量化できると期待されています。
ごはんで言えば、「ご飯をよそった。ご飯を食べた。」を逆にするようなものです。話の筋が、おかしくなりますよね。人なら気づく「順番の不自然さ」を、確率から数字にしようとしているわけです。
熱力学の枠組みで見た実験は「傾向が見られた」段階
この熱力学の枠組みで、実際の言語モデルも調べています。実験には、オープンモデルの GPT-2(124M)と Qwen3-4B-Base が使われました。どちらも、プレスリリースでは「比較的小規模な学習済みオープンモデル」とされています。
比べたのは、独立した事実を並べた文章と、出来事が順に進む文章です。その結果、出来事が順に進む文章の方が、エントロピー生成が大きくなる傾向が見られました。文単位で逆順にした生成が、相対的に起きにくい傾向です。
プレスリリースの概要は、この結果をこう表現しています。文章に表れた出来事の順序関係が、モデルに反映されていることを「示唆する」結果、です。
また、論文の要旨(英語)には、次のように書かれています。
- トークン単位のエントロピー生成は、大部分が文法上の産物(a syntactic artifact)
- 文単位のエントロピー生成は、因果的でない文章群より、因果的な順序の文章群の方が大きくなる傾向がある(tends to be larger)
- この観察は、GPT-2 よりかなり大きい(substantially larger)モデルの Qwen3-4B-Base で評価し直しても支持された
文単位の結果は、「傾向がある」「支持された」という書き方です。AI が出来事の順序を理解している、と言い切ってはいません。
この熱力学は、発熱やエネルギー消費の話ではない
「熱力学」と聞くと、AI の電気代や発熱の話を思い浮かべるかもしれません。でも、今回の研究はそういう話ではありません。
プレスリリースの用語解説には、次の説明があります。伝統的な熱力学では、エントロピー生成は発熱やエネルギー消費と関係します。一方、この研究が量にしているのは、自己回帰生成モデルの生成過程の不可逆性です。
そのため、ここでのエントロピー生成は、物理的な発熱やエネルギー消費そのものに対応するわけではありません。用語解説は、モデルを動かすコンピューターの半導体などを例に、そう明記しています。
だから、「AI の消費電力を減らす研究」と紹介すると誤解になります。ここは押さえておきたいところです。
これからの検証と、熱力学で「世界モデル」を調べる期待
ただし、今回の実験には注意点があります。評価に使った文章群は、商用の生成AIにプロンプトで指示して作ったものです。
プレスリリースは、今後のさらなる検証が望まれるとしています。たとえば、順序関係や因果関係の理論的な定義に基づいて、文章群を作る方法です。
その先にあるのが「世界モデル」です。生成AIの内部に形成されると考えられている、現実世界の表現のことです。今回の成果は、その定量的な理解につながることが期待されています。
また、プレスリリースは、生成AIが学習で獲得した現実世界についての表現を、熱力学に基づいて解析する新たな道筋を示すことも期待されるとしています。あくまで期待の表現で、世界モデルがあると証明したわけではありません。
なお、ChatGPT などの商用の大規模モデルに当てはめる予定は、今回の発表には書かれていません。AI の評価・改善に使う、実用化の予定も同じです。
このニュースを読むときに押さえておきたいこと
製品やサービスが変わる話ではないので、利用者がすぐにやることはありません。読み物として楽しむなら、おすすめの見方は次の 3 つです。
- 「AI が時間の向きを理解していると証明された」とは受け取らない(結果は「示唆」「傾向」の段階)
- 実験に使われたのは、比較的小規模なオープンモデル 2 つだと覚えておく
- ここでの熱力学のエントロピー生成は、物理的な発熱やエネルギー消費そのものに対応するものではないと知っておく
AI は答えを出してくれても、中で何が起きているかは見えにくいものです。今回の研究は、その中身を熱力学の物差しで測ろうとする試みです。今後の検証も、追いかけたいですね。
研究は、JST 戦略的創造研究推進事業 ERATO(課題番号 JPMJER2302)の支援を受けています。東京大学 Beyond AI 研究推進機構も、支援に加わっています。
2026年11月7日時点の情報です。ほかの IT の話題は、技術ネタカテゴリーからどうぞ。
ITもごはんも、腹八分目が長続きのコツ!
コメント